Baza danych w aplikacji webowej rzadko jest widoczna dla użytkownika, ale to właśnie w niej kumuluje się największa część ryzyka biznesowego, operacyjnego i regulacyjnego. Z perspektywy konsultanta IT widzę, że problemy nie wynikają zwykle z wyboru między PostgreSQL a MySQL, lecz z braku architektury bezpieczeństwa, odpowiedzialności i testowalnych procesów.
Dlaczego baza danych jest krytycznym elementem aplikacji webowej
Aplikacje webowe przetwarzają dziś znacznie więcej niż podstawowe dane kontaktowe. W bazach zapisują się profile klientów, historia zamówień, dokumenty, dane pracowników, zgłoszenia serwisowe, informacje o płatnościach, logi aktywności, a coraz częściej również dane wykorzystywane przez moduły AI. Każdy taki zasób może mieć inną wartość, okres retencji i poziom ochrony.
W praktyce baza danych nie jest wyłącznie komponentem technicznym. Jest miejscem, w którym spotykają się wymagania biznesowe, prawa dostępu, kopie zapasowe, ciągłość działania oraz obowiązki wynikające z GDPR. Jeżeli system obsługuje podmiot objęty regulacjami sektorowymi lub wymogami NIS 2, baza staje się też istotnym elementem zarządzania ryzykiem cyberbezpieczeństwa.
Dobrze zaprojektowana aplikacja webowa powinna traktować bazę jako odrębną strefę zaufania. Oznacza to, że użytkownik nie łączy się z nią bezpośrednio, serwer aplikacyjny korzysta z ograniczonego konta technicznego, a administratorzy mają nadawane uprawnienia zgodnie z konkretną rolą. Jest to istotne zarówno podczas tworzenia aplikacji webowych, jak i przy modernizacji systemu działającego od wielu lat.
Studium przypadku: portal B2B z ukrytym ryzykiem w bazie danych
Przedstawiony przykład dotyczy średniej firmy dystrybucyjnej z Polski, którą na potrzeby artykułu nazwiemy NordTrade. Firma obsługiwała około 1 800 aktywnych klientów biznesowych, prowadziła sprzedaż w Polsce i kilku krajach UE oraz zatrudniała 140 osób. Jej portal B2B umożliwiał składanie zamówień, dostęp do faktur, pobieranie dokumentów jakościowych i zgłaszanie reklamacji.
System był rozwijany przez osiem lat. Część funkcji powstała w początkowej wersji aplikacji, kolejne dodawano po przejęciach i zmianach procesów sprzedaży. Frontend działał poprawnie, a użytkownicy oceniali portal jako wygodny. Problem ujawnił się dopiero wtedy, gdy firma rozpoczęła przygotowania do wymagań związanych z ISO 27001 oraz analizę obowiązków wynikających z NIS 2 dla łańcucha dostaw.
Podczas przeglądu odkryliśmy, że jedna baza PostgreSQL obsługiwała portal klientów, panel administracyjny, integrację z ERP, usługę raportową i środowisko testowe. Do tego samego klastra łączyło się 27 kont technicznych. Kilka z nich miało uprawnienia administracyjne, mimo że wykorzystywały je tylko do odczytu danych zamówień. Hasła części kont były zapisane w zmiennych środowiskowych na serwerze, a historia zmian uprawnień nie była rejestrowana.
Nie doszło do potwierdzonego naruszenia danych osobowych. Firma miała jednak realny problem: nie potrafiła wiarygodnie odpowiedzieć, kto miał dostęp do danych klientów, jakie informacje mógł zmienić i czy kopie zapasowe dałoby się odtworzyć w wymaganym czasie. Z perspektywy GDPR była to luka w wykazywalności odpowiednich środków technicznych i organizacyjnych. Z perspektywy ISO 27001 oznaczała brak dojrzałych kontroli dostępu, zarządzania konfiguracją i ciągłości działania.
Punkt wyjścia: architektura, która działała, ale nie była bezpieczna
Najtrudniejszą częścią zadania nie było samo wdrożenie szyfrowania czy nowego mechanizmu backupu. Najpierw należało zrozumieć przepływ danych. Zespół NordTrade zakładał, że w bazie są tylko dane kontrahentów i zamówień. W rzeczywistości znajdowały się tam także adresy prywatne kontaktów, numery telefonów, uwagi do reklamacji, załączniki z podpisami oraz eksporty z działu handlowego.
Wykryliśmy pięć głównych problemów:
- jedno uprzywilejowane konto bazy danych wykorzystywane przez kilka usług
- brak separacji środowisk produkcyjnego, testowego i analitycznego
- dane produkcyjne kopiowane do testów bez anonimizacji
- brak centralnego rejestrowania zapytań administracyjnych i zmian schematu
- kopie zapasowe wykonywane regularnie, ale bez okresowych testów odtworzenia
Takie środowisko jest częste w firmach, które rosły szybciej niż ich procesy IT. Początkowo priorytetem jest szybkie uruchomienie nowej funkcji. Z czasem pojedyncze wyjątki stają się standardem, a standard staje się trudny do zmiany, ponieważ nikt nie ma pełnej mapy zależności.
Model ochrony danych w aplikacji webowej
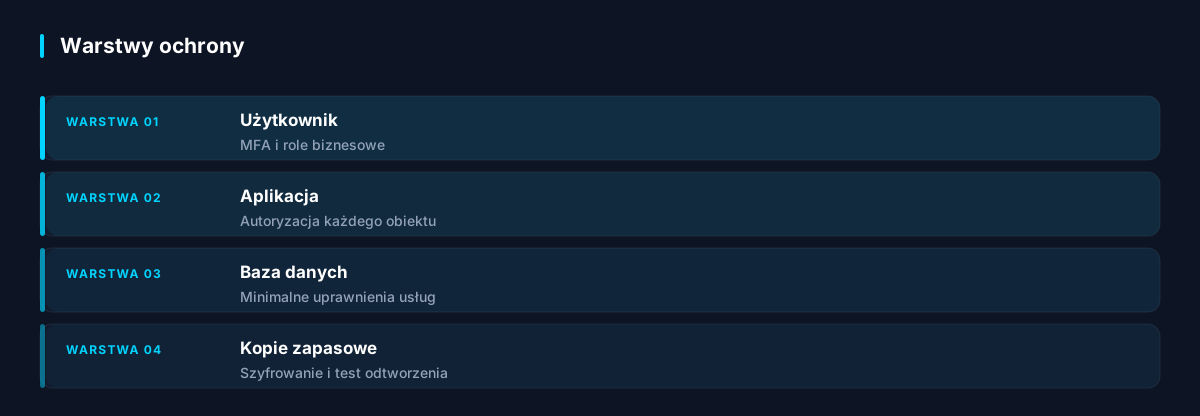
Skuteczne zabezpieczenie bazy nie polega na jednym narzędziu. Potrzebny jest zestaw nakładających się warstw, z których każda ogranicza skutki błędu człowieka, podatności aplikacji lub przejęcia konta.
W przypadku NordTrade przyjęliśmy zasadę, że każda warstwa musi odpowiadać na konkretne pytanie: kto może uzyskać dostęp, do jakich danych, z jakiej usługi, w jakim celu i czy zdarzenie można później odtworzyć na podstawie logów. To podejście jest zgodne z praktyką zarządzania ryzykiem wymaganą przez ISO 27001 i przydatne podczas wdrożenia ISO 27001.
Jak wykryliśmy problem bez przerywania pracy portalu
Audyt rozpoczęliśmy od inwentaryzacji, a nie od skanowania podatności. Zebraliśmy listę baz, instancji, schematów, kont, integracji, harmonogramów zadań i repozytoriów kodu. Następnie porównaliśmy ją z rejestrem czynności przetwarzania, umowami z dostawcami oraz dokumentacją infrastruktury. Już na tym etapie ujawniono istotną rozbieżność: formalny rejestr wskazywał siedem kategorii danych osobowych, a analiza tabel i załączników wykazała jedenaście.
Kolejnym krokiem był przegląd uprawnień. Nie ograniczyliśmy się do sprawdzenia listy użytkowników. Analizowaliśmy efektywne prawa dziedziczone przez role, dostęp do funkcji, konta serwisowe oraz połączenia z adresów administracyjnych. Ustaliliśmy, że konto raportowe mogło wykonywać operacje usuwania w tabeli reklamacji, choć żaden raport nie wymagał takiego prawa.
Przeprowadziliśmy też kontrolowane testy aplikacji webowej. Sprawdziliśmy parametryzację zapytań, autoryzację na poziomie obiektów, obsługę błędów i limity zapytań. Kod był w dużej części odporny na SQL injection, ale znaleźliśmy lukę typu IDOR. Użytkownik, który zmienił identyfikator dokumentu w adresie, mógł pobrać fakturę innego klienta, jeśli znał przewidywalny numer rekordu. Sama baza danych nie była przyczyną tej podatności, ale jej konstrukcja i brak dodatkowej kontroli dostępu zwiększały zasięg problemu.
Właśnie dlatego audyt cyberbezpieczeństwa powinien obejmować jednocześnie aplikację, bazę, infrastrukturę i procesy operacyjne. Test wyłącznie kodu pomija uprawnienia techniczne. Przegląd wyłącznie serwerów nie pokaże błędów w logice autoryzacji.
Plan naprawczy: od ryzyka do mierzalnych kontroli
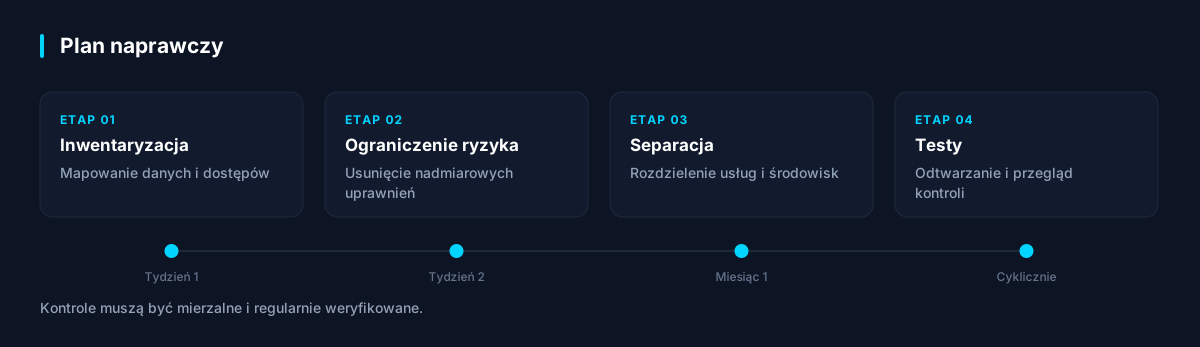
Plan podzieliliśmy na działania możliwe do wykonania bez długiego przestoju oraz zmiany architektoniczne wymagające przygotowania. Zarząd otrzymał listę ryzyk opisaną językiem biznesowym: możliwe ujawnienie danych klienta, zatrzymanie sprzedaży B2B, brak możliwości odtworzenia systemu oraz trudność w wykazaniu zgodności podczas kontroli.
Pierwsze działania miały charakter pilny. Odebrano nadmiarowe uprawnienia, wyłączono nieużywane konta, zmieniono sekrety dostępowe i usunięto dane produkcyjne ze środowiska testowego. Równolegle poprawiono autoryzację dokumentów w aplikacji, aby każda operacja była weryfikowana względem organizacji zalogowanego użytkownika, a nie tylko identyfikatora obiektu.
W drugim etapie wprowadzono osobne konta dla każdej usługi oraz zasadę minimalnych uprawnień. Konto integracji ERP mogło dodawać i aktualizować wyłącznie potrzebne rekordy. Konto raportowe otrzymało dostęp tylko do widoków przeznaczonych do odczytu. Administratorzy korzystali z osobnych kont uprzywilejowanych, chronionych MFA i dostępnych tylko przez kontrolowany punkt administracyjny.
W trzecim etapie rozdzielono środowiska. Dane do testów zastąpiono zanonimizowanym zestawem, zachowując strukturę niezbędną programistom. To ważne w świetle GDPR: pseudonimizacja ogranicza ryzyko, ale dane nadal mogą pozostać danymi osobowymi. Jeżeli zespół testowy nie potrzebuje prawdziwych danych, bezpieczniej zastosować anonimizację albo dane syntetyczne.
Backup, szyfrowanie i odtwarzanie: trzy różne mechanizmy
Jednym z najczęstszych błędów jest przekonanie, że codzienny backup rozwiązuje problem odporności systemu. Backup może istnieć, a mimo to nie gwarantować odtworzenia usługi. Kopia może być niepełna, zaszyfrowana przez atak ransomware, przechowywana w tej samej strefie co produkcja albo po prostu niezgodna z aktualną wersją aplikacji.
W NordTrade wdrożono zasadę 3-2-1. Utrzymywane są co najmniej trzy kopie danych, na dwóch różnych typach nośników, w tym jedna poza podstawową lokalizacją lub logicznie odseparowana. Kopie są szyfrowane, dostęp do nich ograniczony, a klucze szyfrujące zarządzane oddzielnie od danych. Najważniejsza zmiana dotyczyła jednak testów odtworzeniowych.
Raz na kwartał zespół odtwarza wybraną kopię w izolowanym środowisku i mierzy dwa parametry. RPO określa, ile danych firma może maksymalnie utracić, a RTO wskazuje maksymalny dopuszczalny czas przywrócenia usługi. Dla portalu ustalono RPO na cztery godziny i RTO na osiem godzin. Dopiero regularny test pokazał, czy te wartości są realne, a nie tylko wpisane do procedury.
Regulacje: GDPR, NIS 2 i ISO 27001 w codziennej pracy
GDPR nie wskazuje jednej obowiązkowej technologii bazy danych. Wymaga natomiast wdrożenia środków adekwatnych do ryzyka, uwzględniających stan wiedzy technicznej, koszt wdrożenia, charakter przetwarzania i potencjalne skutki dla osób. W praktyce dla bazy danych oznacza to między innymi kontrolę dostępu, poufność transmisji, możliwość odtworzenia dostępności, regularne testowanie zabezpieczeń oraz zarządzanie retencją danych.
W polskim otoczeniu prawnym trzeba uwzględnić GDPR oraz krajowe przepisy o ochronie danych osobowych. Organizacje objęte albo pośrednio dotknięte wymogami NIS 2 powinny analizować bazę danych jako zasób wspierający usługi kluczowe lub ważne. Szczególne znaczenie mają zarządzanie incydentami, bezpieczeństwo łańcucha dostaw, ciągłość działania, zarządzanie podatnościami i odpowiedzialność kierownictwa. Więcej praktycznego kontekstu dla takich organizacji przedstawia materiał o zgodności z NIS 2.
ISO 27001 pomaga przełożyć ogólne wymagania na system zarządzania. Nie jest listą gotowych konfiguracji PostgreSQL czy MySQL. Wymaga jednak, aby firma potrafiła zidentyfikować aktywa, ocenić ryzyko, wdrożyć kontrole, przypisać właścicieli i sprawdzać skuteczność działań. W NordTrade właścicielem danych klientów został dyrektor sprzedaży, właścicielem procesu odtwarzania kierownik IT, a właścicielem kontroli dostępów wyznaczony administrator bezpieczeństwa.
Jeżeli aplikacja wykorzystuje modele AI do klasyfikowania zgłoszeń, rekomendacji czy oceny klientów, trzeba ponadto ustalić, jakie dane trafiają do modelu i dostawcy usługi. W zależności od zastosowania znaczenie mogą mieć obowiązki z EU AI Act oraz zasady minimalizacji danych z GDPR. Warto zaplanować to na etapie doradztwa AI i zgodności z EU AI Act, zamiast dopisywać zabezpieczenia po uruchomieniu funkcji.
Praktyczna lista kontrolna dla firmy
Poniższe pytania warto zadać przed wdrożeniem nowej aplikacji webowej albo podczas przeglądu istniejącego systemu:
- Czy istnieje aktualna lista baz danych, tabel wrażliwych, integracji i właścicieli biznesowych?
- Czy każda usługa ma własne konto techniczne z minimalnym zakresem uprawnień?
- Czy użytkownik aplikacji może zobaczyć lub zmienić wyłącznie dane swojej organizacji?
- Czy dane produkcyjne są wykluczone ze środowisk testowych albo odpowiednio zanonimizowane?
- Czy połączenia do bazy są szyfrowane, a sekrety przechowywane poza kodem i plikami konfiguracyjnymi?
- Czy logi pozwalają ustalić, kto i kiedy zmienił uprawnienia, strukturę danych lub rekordy wrażliwe?
- Czy firma testuje odtworzenie backupu oraz zna rzeczywiste RPO i RTO?
- Czy retencja danych jest zdefiniowana, a usuwanie rekordów realizowane zgodnie z procesem biznesowym i prawnym?
- Czy dostawcy hostingu, monitoringu, backupu i AI są ujęci w ocenie ryzyka oraz w dokumentacji powierzenia danych?
Efekt po sześciu miesiącach
Po sześciu miesiącach NordTrade miała nie tylko bezpieczniejszą bazę danych, lecz także lepszą kontrolę nad rozwojem aplikacji. Każda nowa funkcja przechodziła przez krótką ocenę wpływu na dane, a zmiany w schemacie były zatwierdzane i automatycznie rejestrowane. Zespół programistyczny otrzymał bibliotekę do autoryzacji obiektowej oraz standard obsługi sekretów, co ograniczyło ryzyko powrotu do poprzednich praktyk.
Największą wartością nie było wdrożenie pojedynczego narzędzia. Firma zyskała zdolność do udowodnienia, gdzie są dane, kto ma do nich dostęp, jak są chronione i jak szybko można przywrócić działanie portalu. Ta zdolność ma znaczenie podczas audytu, obsługi incydentu, kontroli kontrahenta i codziennego rozwoju systemu.
Bezpieczna baza danych w aplikacji webowej wymaga połączenia właściwej architektury, kontroli dostępu, testów odtworzeniowych i jasnej odpowiedzialności za dane. Problem, z którym zostaje wiele firm, nie brzmi więc: jaka baza będzie najlepsza, lecz: czy potrafimy wykazać, że dane w obecnej bazie są rzeczywiście pod kontrolą?
Opublikowano 28 września 2026 przez Dariusz Zalewski
← Wróć do wszystkich artykułów